15. الفهرسة المكانية
تذكّر أن الفهرس المكاني إحدى الميزات الرئيسية الثلاث لقاعدة البيانات المكانية. فالفهارس تجعل استخدام قاعدة بيانات مكانية لمجموعات البيانات الكبيرة ممكنًا. فبدون الفهرسة، يتطلب أي بحث عن معلم «مسحًا تسلسليًا» لكل سجل في قاعدة البيانات. تُسرّع الفهرسة البحث بتنظيم البيانات في شجرة بحث يمكن اجتيازها بسرعة للعثور على سجل معين.
تُعدّ الفهارس المكانية من أعظم مزايا PostGIS. في المثال السابق، تتطلب عمليات الربط المكاني مقارنة جداول كاملة بعضها ببعض، وقد يصبح ذلك مكلفًا جدًا: فربط جدولين يحتوي كل منهما على 10,000 سجل دون فهارس يتطلب 100,000,000 مقارنة، أما مع الفهارس فقد تنخفض التكلفة إلى 20,000 مقارنة فقط.
تضمّن ملف تحميل البيانات لدينا فهارس مكانية لجميع الجداول مسبقًا، لذا سنحتاج أولًا إلى حذفها كي نوضّح مدى فاعلية الفهارس.
لننفّذ استعلامًا على nyc_census_blocks دون الفهرس المكاني.
خطوتنا الأولى هي حذف الفهرس.
DROP INDEX nyc_census_blocks_geom_idx;
ملاحظة
تحذف التعليمة DROP INDEX فهرسًا موجودًا من نظام قاعدة البيانات. لمزيد من المعلومات، راجع توثيق PostgreSQL.
راقب الآن عدّاد "Timing" في الزاوية اليمنى السفلى من نافذة الاستعلام في pgAdmin ونفّذ ما يلي. يبحث استعلامنا في كل كتلة إحصائية (census block) لتحديد الكتل التي تحتوي على محطات مترو تبدأ أسماؤها بالحرف "B".
SELECT count(blocks.blkid)
 FROM nyc_census_blocks blocks
 JOIN nyc_subway_stations subways
 ON ST_Contains(blocks.geom, subways.geom)
 WHERE subways.name LIKE 'B%';
    count
---------------
    46
الجدول nyc_census_blocks صغير جدًا (بضعة آلاف من السجلات فقط)، لذا لا يستغرق الاستعلام حتى دون فهرس سوى 300 ms على حاسوب الاختبار لديّ.
أضف الفهرس المكاني مجددًا ثم نفّذ الاستعلام مرة أخرى.
CREATE INDEX nyc_census_blocks_geom_idx
  ON nyc_census_blocks
  USING GIST (geom);
ملاحظة
يُخبر البند USING GIST نظام PostgreSQL باستخدام بنية الفهرس العامة (GIST) عند بناء الفهرس. إذا ظهر لك خطأ يشبه ERROR: index row requires 11340 bytes, maximum size is 8191 عند إنشاء الفهرس، فالأرجح أنك أغفلت إضافة البند USING GIST.
على حاسوب الاختبار لديّ ينخفض الزمن إلى 50 ms. وكلما كبر حجم الجدول، كان التحسّن النسبي في سرعة الاستعلام المفهرس أكبر.
15.1. كيف تعمل الفهارس المكانية
تُنشئ فهارس قواعد البيانات القياسية شجرة هرمية مبنية على قيم العمود المفهرس. أما الفهارس المكانية فمختلفة قليلًا، إذ لا يمكنها فهرسة المعالم الهندسية نفسها، فتفهرس بدلًا من ذلك المستطيلات المحيطة (bounding boxes) بالمعالم.
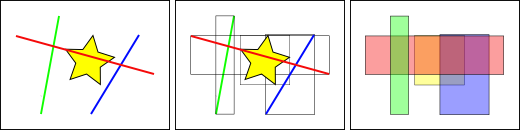
في الشكل أعلاه، عدد الخطوط التي تتقاطع مع النجمة الصفراء هو واحد، وهو الخط الأحمر. لكن عدد المستطيلات المحيطة بالمعالم التي تتقاطع مع المربع الأصفر هو اثنان، الأحمر والأزرق.
الطريقة التي تجيب بها قاعدة البيانات بكفاءة عن السؤال "ما الخطوط التي تتقاطع مع النجمة الصفراء" هي أن تجيب أولًا عن السؤال "ما المستطيلات التي تتقاطع مع المربع الأصفر" باستخدام الفهرس (وهذا سريع جدًا)، ثم تُجري حسابًا دقيقًا لـ "ما الخطوط التي تتقاطع مع النجمة الصفراء" على المعالم التي أعادها الاختبار الأول فقط.
في الجداول الكبيرة، يمكن لنظام "المرحلتين" هذا، أي تقييم الفهرس التقريبي أولًا ثم إجراء اختبار دقيق، أن يقلّل جذريًا كمية الحسابات اللازمة للإجابة عن الاستعلام.
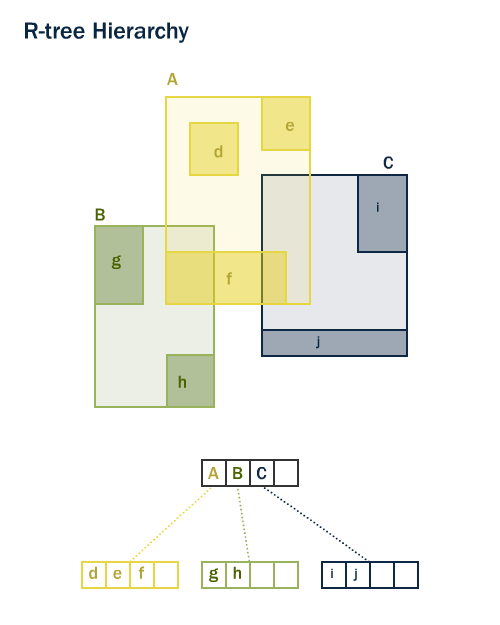
يشترك كل من PostGIS و Oracle Spatial في بنية الفهرس المكاني نفسها "R-Tree" [1]. تقسّم أشجار R-Tree البيانات إلى مستطيلات، ومستطيلات فرعية، ومستطيلات فرعية داخلها، وهكذا. وهي بنية فهرس ذاتية الضبط تتعامل تلقائيًا مع تفاوت كثافة البيانات واختلاف مقدار تداخل الكائنات وأحجامها.
15.2. الدوال التي تستخدم الفهرس المكاني
لا تستفيد تلقائيًا من الفهرس المكاني، عند توفره، سوى مجموعة جزئية من الدوال.
الدوال الأربع الأولى هي الأكثر استخدامًا في الاستعلامات، والدالة ST_DWithin مهمة جدًا لتنفيذ استعلامات من نوع "ضمن مسافة" أو "ضمن نصف قطر" مع الاستفادة في الوقت نفسه من تحسين الأداء الذي يوفره الفهرس.
لإضافة تسريع الفهرس إلى دوال أخرى غير موجودة في هذه القائمة (وأشهرها ST_Relate)، أضف بندًا خاصًا بالفهرس فقط كما هو موضح أدناه.
15.3. الاستعلامات المعتمدة على الفهرس فقط
تتضمن معظم الدوال الشائعة الاستخدام في PostGIS (ST_Contains، ST_Intersects، ST_DWithin، وغيرها) مرشّح فهرس تلقائيًا. لكن بعض الدوال (مثل ST_Relate) لا تتضمن مرشّح فهرس.
لإجراء بحث بالمستطيل المحيط باستخدام الفهرس (ودون أي ترشيح إضافي)، استخدم المعامل &&. بالنسبة للأشكال الهندسية، يعني المعامل && "المستطيلات المحيطة متداخلة أو متلامسة"، تمامًا كما يعني المعامل = بالنسبة للأعداد "القيم متساوية".
لنقارن استعلامًا معتمدًا على الفهرس فقط لحساب عدد سكان 'West Village' باستعلام أكثر دقة. باستخدام && يبدو استعلامنا المعتمد على الفهرس فقط كما يلي:
SELECT Sum(popn_total)
FROM nyc_neighborhoods neighborhoods
JOIN nyc_census_blocks blocks
ON neighborhoods.geom && blocks.geom
WHERE neighborhoods.name = 'West Village';
49821
لننفّذ الآن الاستعلام نفسه باستخدام الدالة الأدق ST_Intersects.
SELECT Sum(popn_total)
FROM nyc_neighborhoods neighborhoods
JOIN nyc_census_blocks blocks
ON ST_Intersects(neighborhoods.geom, blocks.geom)
WHERE neighborhoods.name = 'West Village';
26718
النتيجة أقل بكثير! جمع الاستعلام الأول كل الكتل التي يتقاطع مستطيلها المحيط مع المستطيل المحيط بالحي، أما الاستعلام الثاني فلم يجمع إلا الكتل التي تتقاطع مع الحي نفسه.
15.4. التحليل (ANALYZE)
يختار مخطِّط الاستعلامات في PostgreSQL بذكاء متى يستخدم الفهارس ومتى لا يستخدمها لتقييم الاستعلام. وعلى عكس المتوقع، فإن البحث عبر الفهرس ليس دائمًا أسرع: فإذا كان البحث سيعيد كل سجلات الجدول، فإن اجتياز شجرة الفهرس للوصول إلى كل سجل سيكون في الواقع أبطأ من قراءة الجدول كاملًا بالتتابع من بدايته.
معرفة حجم مستطيل الاستعلام لا تكفي لتحديد ما إذا كان الاستعلام سيعيد عددًا كبيرًا أو صغيرًا من السجلات. في الشكل أدناه، المربع الأحمر صغير، لكنه سيعيد سجلات أكثر بكثير من المربع الأزرق.
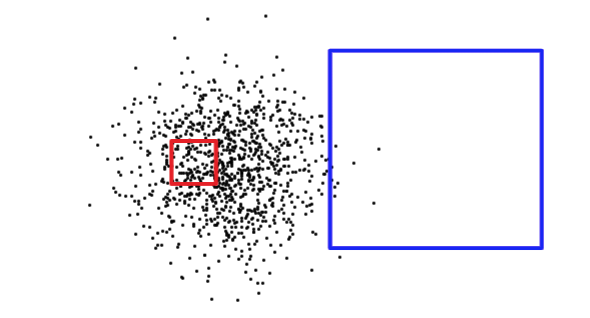
لكي يعرف PostgreSQL الحالة التي يتعامل معها (قراءة جزء صغير من الجدول أم جزء كبير منه)، فإنه يحتفظ بإحصاءات عن توزيع البيانات في كل عمود مفهرس من أعمدة الجدول. يجمع PostgreSQL الإحصاءات افتراضيًا بشكل دوري. لكن إذا غيّرت محتويات جدولك تغييرًا كبيرًا خلال فترة قصيرة، فلن تكون الإحصاءات محدّثة.
لضمان تطابق الإحصاءات مع محتويات جدولك، من الحكمة تنفيذ الأمر ANALYZE بعد عمليات التحميل والحذف الكبيرة للبيانات في جداولك. يُجبر ذلك نظام الإحصاءات على جمع البيانات لجميع الأعمدة المفهرسة.
يطلب الأمر ANALYZE من PostgreSQL اجتياز الجدول وتحديث إحصاءاته الداخلية المستخدمة في تقدير خطة الاستعلام (سنتناول تحليل خطة الاستعلام لاحقًا).
ANALYZE nyc_census_blocks;
15.5. التنظيف (VACUUM)
تجدر الإشارة إلى أن إنشاء الفهرس وحده لا يكفي ليتمكّن PostgreSQL من استخدامه بفاعلية. يجب إجراء التنظيف (VACUUM) كلما نُفّذ عدد كبير من عمليات UPDATE أو INSERT أو DELETE على الجدول. يطلب الأمر VACUUM من PostgreSQL استرداد أي مساحة غير مستخدمة في صفحات الجدول خلّفتها عمليات تحديث السجلات أو حذفها.
التنظيف بالغ الأهمية لتشغيل قاعدة البيانات بكفاءة، لدرجة أن PostgreSQL يوفّر خاصية "autovacuum" (التنظيف التلقائي) افتراضيًا.
يقوم التنظيف التلقائي بتنظيف جداولك (استرداد المساحة) وتحليلها (تحديث الإحصاءات) على فترات معقولة يحددها مستوى النشاط. ورغم أن ذلك ضروري لقواعد البيانات كثيفة المعاملات، فليس من المستحسن انتظار تشغيل التنظيف التلقائي بعد إضافة الفهارس أو تحميل البيانات بكميات كبيرة. كلما نفّذت تحديثًا جماعيًا كبيرًا، يجب أن تشغّل VACUUM يدويًا.
يمكن تنظيف قاعدة البيانات وتحليلها كلٌّ على حدة حسب الحاجة. تنفيذ الأمر VACUUM لن يحدّث إحصاءات قاعدة البيانات، وكذلك تنفيذ الأمر ANALYZE لن يسترد صفوف الجدول غير المستخدمة. ويمكن تشغيل الأمرين على قاعدة البيانات كاملة أو على جدول واحد أو على عمود واحد.
VACUUM ANALYZE nyc_census_blocks;
15.6. قائمة الدوال
geometry_a && geometry_b: تعيد TRUE إذا كان المستطيل المحيط بـ A يتداخل مع المستطيل المحيط بـ B.
geometry_a = geometry_b: قبل الإصدار PostGIS 2.4 تعيد true إذا كان المستطيل المحيط بـ A مطابقًا للمستطيل المحيط بـ B. ومنذ الإصدار 2.4 تعيد TRUE فقط إذا كان الشكل الهندسي لـ A مطابقًا لـ B.
geometry_a ~= geometry_b: تعيد TRUE إذا كان المستطيل المحيط بـ A مساويًا للمستطيل المحيط بـ B.
ST_Intersects(geometry_a, geometry_b): تعيد TRUE إذا كانت الأشكال الهندسية/الجغرافية "متقاطعة مكانيًا" (تشترك في أي جزء من الحيّز)، و FALSE إذا لم تكن كذلك (أي منفصلة).
الحواشي